 字节 AI 全栈开发挑战赛 · Agent 编排 · 前三名
Roundtable
一个群聊形态的多 Agent 协作平台:Agent 团队接过目标,自己商量方案、自己分工,用户在三道关口上掌握全局。
- 赛事
- 字节跳动 AI 全栈开发挑战赛
- 成绩
- 前三名,决赛 demo 展示
- 角色
- 队长
- 模型
- Seed 2.0 Pro
业务问题
多 Agent 协作现在已经能做复杂的开发任务,但用起来有两个问题。
一是门槛高:任务怎么拆、派给哪些 Agent、按什么顺序协作,全靠用户自己编排,AI coding 的新手上不了手。二是复用差:有经验的用户能搭出好用的流程,但每次都要从头搭,好的流程沉淀不下来。
业务场景
为什么会这样,要看多 Agent 协作这件事本身。之所以要用多个 Agent,是因为有些复杂任务单个 Agent 做不好,需要拆开,交给不同的 Agent 分工完成。所以它本质上是一个任务拆解问题:拆得好不好,直接决定最后产出的效果。
现在拆解这件事完全压在用户身上。新手不知道该怎么拆,所以门槛高;老手拆得好,但每次都要重新拆一遍,所以复用差。
而工作流就是把一种拆解方式固定下来:谁来做、按什么顺序、怎么交接都确定了,多 Agent 协作就变得可控。但现有的做法是两个极端:要么只给一套固定流程,可控但不够灵活;要么完全开放编排,灵活但又回到了靠用户自己拆。
所以我们的产品围绕两件事来设计:拆解交给 Agent 来做,同时让整个过程对用户可控。
产品形态
Roundtable 是一个群聊形态的多 Agent 协作平台。用户挑选几个 Agent 组成团队,设定一个目标,剩下的由 Agent 团队协作完成。
拆解交给 Agent 来做。 系统先根据任务推荐一套工作流,也就是一种现成的拆解方式。Agent 们在这个基础上讨论出执行方案,再由 PM Agent 把方案拆成具体任务,分发给各个 Agent。跑通的工作流可以通过可视化编辑器和模板市场沉淀下来,被直接复用。
可控靠三道关:
- 执行前,方案要经过用户 review。
- 执行中,PM Agent 监督进度,遇到问题及时上升给用户。
- 交付前,产出要先通过测试 Agent 的测试。
我的工作
我主要做了两件事,都在拆解这一侧。
规划入口的工作流推荐。 拆解的第一步是选对协作方式,这一步选错,后面所有节点的执行成本都白费。所以我把成功标准定为准确识别每个工作流的适用边界,并且能区分容易混淆的场景。做法分三步:
- 元数据。 给每个工作流定义元数据:任务类型、适用场景、Agent 角色、输入输出、流程节点和约束。
- 评测集。 搭了一个 30 条的评测集,专门放进容易混淆的 case。
- badcase 归因。 根因是模型缺少对这些工作流的知识。于是加了 5 个带正反例和推理解释的 few-shot,用 ICE 结构的 prompt 加 schema 结构化输出来避免幻觉。
Seed 2.0 Pro 的准确识别率从 16/30 提到 28/30,提升 40 个百分点。
把好的拆解方式沉淀下来。 我做了可视化编辑器和模板市场。跑通的工作流可以保存、修改、被别人直接复用:老手不用每次重搭,新手也有现成的可以用。
最后,我带团队拿到了字节 AI 全栈开发挑战赛前三,并在决赛做了 demo 展示。
怎么衡量
怎么衡量拆解做得好不好?我们现在量的是入口这一环:规划入口的准确识别率,也就是在包含易混淆 case 的评测集上,系统推荐的是不是正确的那套工作流,目前是 28/30。选这个指标,是因为入口一旦选错,下游全部白做,它是产出质量的前提。
这是一个比赛周期内的项目,端到端的效果还没有系统地量。如果继续做,我会补两个指标:
- 产出质量:测试 Agent 的一次通过率。
- 复用:有多少任务是从模板启动的。
在线演示
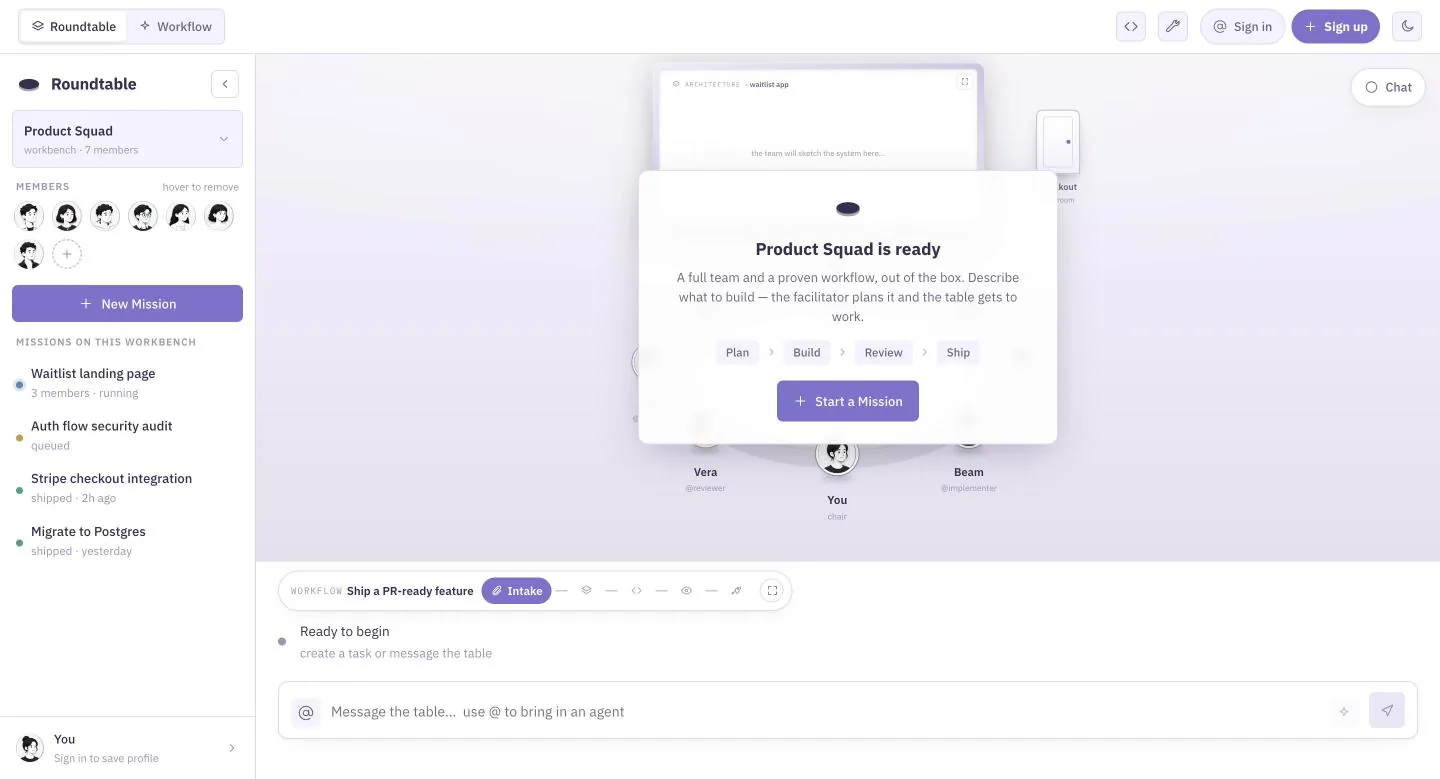
这是真实的应用,直接运行在本页中,全屏可以占满整个窗口。如果加载不出来(vercel.app 在部分地区无法访问),请在新标签页中打开。
画板
拖动画布移动 · ⌘ / Ctrl + 滚轮或双指缩放 · 全屏查看更清楚
成果
- 16 → 28(共 30 条)
- 规划入口正确识别的工作流数(Seed 2.0 Pro),提升 40 个百分点
- 前三名
- 字节跳动 AI 全栈开发挑战赛,决赛 demo 展示